SCI 논문의 심사위원은 초록을 읽은 뒤 무엇을 먼저 볼까요? 대부분 테이블과 그래프로 곧장 시선을 옮깁니다. 연구의 신뢰성과 완성도를 판단하는 첫 번째 관문이 바로 이 테이블이기 때문입니다. 그만큼 테이블 하나의 품질이 논문 전체의 첫인상을 결정합니다.
그런데 많은 연구자들이 테이블 작성에서 반복되는 실수를 범합니다. 단위 표기를 빠뜨리거나, 소수점 자릿수를 맞추지 않거나, 각주를 애매하게 달거나, 캡션이 너무 짧아 독립적으로 이해되지 않는 경우들입니다. 이런 사소한 오류들이 모이면 리뷰어에게 ‘데이터를 제대로 이해하고 있는가?’라는 의심을 심어줍니다.
그럼에도 불구하고 많은 대학원생과 신진 연구자들이 테이블 작성에서 반복적인 실수를 저지릅니다. 단위(Unit)를 빠뜨리거나, 소수점 자릿수가 통일되지 않거나, 각주(Footnote)가 모호하게 작성되거나, 테이블 제목(Caption)이 지나치게 짧아 독립적으로 이해되지 않는 경우가 대표적입니다. 이러한 실수들은 리뷰어에게 ‘이 연구자는 데이터를 제대로 이해하고 있는가?’라는 의심을 품게 만들고, 결국 메이저 리비전(Major Revision) 또는 리젝션(Rejection)으로 이어지는 원인이 됩니다.
이 글에서는 SCI 논문 테이블을 처음부터 끝까지 완벽하게 작성하는 7단계 전략을 실전 예시와 함께 상세히 안내합니다. 단계별로 따라가다 보면, 심사위원이 바로 인정하는 수준의 테이블을 누구나 작성할 수 있게 됩니다.
1단계: 테이블이 필요한지 먼저 판단하라
테이블 작성의 첫 번째 단계는 역설적으로 ‘테이블이 정말 필요한가’를 판단하는 것입니다. 모든 데이터를 테이블로 만들 필요는 없습니다. 오히려 불필요한 테이블은 논문의 흐름을 방해하고, 리뷰어에게 ‘저자가 본문 서술 능력이 부족하다’는 인상을 줄 수 있습니다.
일반적으로 테이블이 적합한 경우는 다음과 같습니다. 첫째, 비교해야 할 변수(Variable)가 3개 이상이고 각 조건(Condition)이 2개 이상인 경우입니다. 둘째, 수치 데이터가 정밀한 비교를 요구할 때, 즉 피겨로 표현하면 정확한 값을 읽기 어려울 때입니다. 셋째, 여러 그룹의 특성(Characteristic)을 한눈에 요약해야 하는 경우, 예를 들어 임상 연구(Clinical Study)에서의 인구통계학적(Demographic) 정보 요약이 이에 해당합니다.
반면, 데이터 포인트가 3개 이하이거나, 단순한 증가·감소 경향만 보여주면 될 때는 본문 문장이나 피겨가 더 효과적입니다. 저널(Journal)마다 테이블 수 제한이 있는 경우도 많으므로, 투고 전 저자 가이드라인(Author Guidelines)을 반드시 확인해야 합니다.
2단계: 데이터 구조화(Data Structuring) – 행과 열의 논리적 배치
테이블의 뼈대는 행(Row)과 열(Column)의 구조입니다. 이 구조를 어떻게 설계하느냐에 따라 독자가 데이터를 얼마나 쉽게 이해할 수 있는지가 결정됩니다. 데이터 구조화는 단순히 엑셀(Excel)에 숫자를 넣는 작업이 아니라, 연구의 논리 흐름을 시각적으로 표현하는 작업입니다.
가장 기본적인 원칙은 독립변수(Independent Variable)를 행에, 종속변수(Dependent Variable)를 열에 배치하는 것입니다. 예를 들어, 여러 촉매(Catalyst) 조건에서의 반응 수율(Yield), 선택성(Selectivity), 전환율(Conversion Rate)을 비교하는 테이블이라면, 각 촉매 조건이 행이 되고 수율·선택성·전환율이 열이 됩니다. 이렇게 하면 독자는 왼쪽에서 오른쪽으로 읽으면서 한 조건에서의 다양한 결과를 한 번에 파악할 수 있습니다.
비교 목적의 테이블에서는 가장 중요한 변수를 맨 왼쪽 열 또는 맨 위 행에 배치해야 합니다. 독자의 시선은 자연스럽게 왼쪽 상단에서 시작하기 때문입니다. 또한 데이터의 논리적 순서(예: 농도 증가 순서, 시간 순서, 알파벳 순서 등)를 일관되게 유지해야 합니다. 임의적인 배열은 리뷰어에게 혼란을 줍니다.
행과 열의 헤더(Header)는 간결하면서도 명확해야 합니다. 헤더가 너무 길면 테이블이 시각적으로 복잡해지고, 너무 짧으면 의미 전달이 불분명해집니다. 헤더에는 반드시 단위(Unit)를 포함시키되, 가능하면 괄호 안에 표기합니다. 예를 들어 ‘Temperature (°C)’, ‘Yield (%)’, ‘Reaction Time (h)’ 형식이 국제적으로 통용되는 표준입니다.
3단계: 단위 표기(Unit Notation) – 국제 표준을 따르는 정확한 방법
단위 표기는 SCI 논문 테이블에서 가장 빈번하게 오류가 발생하는 부분입니다. 잘못된 단위 표기는 데이터의 신뢰성을 직접적으로 훼손하므로, 반드시 국제단위계(SI, Système International d’Unités)를 기준으로 작성해야 합니다.
단위 표기의 핵심 원칙은 다음과 같습니다. 첫째, 단위는 반드시 헤더에만 표기하고, 데이터 셀(Cell) 안에는 숫자만 넣습니다. 예를 들어 ‘Mass (g)’라는 헤더 아래에 ‘5.32’, ‘10.15’, ‘20.00’처럼 숫자만 기재합니다. 각 셀마다 ‘g’를 반복하는 것은 잘못된 방식입니다.
둘째, 복합 단위(Compound Unit)는 슬래시(/) 대신 음의 지수(Negative Exponent)로 표기하는 것이 학술적으로 더 정확합니다. 예를 들어 ‘mol/L’ 대신 ‘mol·L⁻¹’ 또는 ‘mol L⁻¹’로 쓰는 것이 권장됩니다. 단, 저널마다 선호하는 표기 방식이 다를 수 있으므로, 해당 저널의 최근 게재 논문을 참고하여 일관성을 맞추는 것이 좋습니다.
셋째, 퍼센트(%)는 단위가 아닌 무차원(Dimensionless) 비율이므로, 헤더에 ‘Yield (%)’처럼 괄호 안에 넣거나 또는 ‘Yield / %’처럼 슬래시로 구분하여 표기할 수 있습니다. 두 방식 모두 허용되지만, 논문 내에서 일관되게 사용해야 합니다.
넷째, 불확실도(Uncertainty) 또는 표준편차(Standard Deviation, SD)를 함께 표기할 때는 ‘5.32 ± 0.15’ 형식을 사용합니다. 이때 ± 기호 앞뒤에 공백을 넣는 것이 국제 표준입니다. 또한 불확실도의 자릿수는 측정값의 마지막 유효숫자(Significant Figure)와 일치시켜야 합니다. 예를 들어 ‘5.32 ± 0.1’은 잘못된 표기이고, ‘5.32 ± 0.15’가 올바른 표기입니다.
다섯째, 소수점 자릿수는 테이블 내에서 동일한 열에 속한 모든 데이터가 반드시 통일되어야 합니다. ‘5.3’, ‘10.15’, ‘20.1’처럼 자릿수가 들쭉날쭉한 테이블은 데이터 처리 과정에서 오류가 있었음을 암시합니다. 유효숫자(Significant Figure)의 개수도 측정 방법의 정밀도(Precision)와 일치해야 합니다.
4단계: 테이블 제목(Caption) 작성 – 독립적으로 이해되어야 한다
테이블 제목(Table Caption)은 독자가 본문을 읽지 않아도 테이블만 보고 내용을 완전히 이해할 수 있도록 작성해야 합니다. 이것이 테이블 캡션 작성의 핵심 원칙입니다. 많은 연구자들이 캡션을 너무 짧게 쓰는 실수를 범합니다.
잘못된 예시: “Table 1. Experimental results.” 이 캡션은 어떤 실험의 어떤 결과인지 전혀 알 수 없습니다.
올바른 예시: “Table 1. Catalytic performance of various transition metal catalysts for the oxidative dehydrogenation of propane at 500 °C, including propane conversion (%), propylene selectivity (%), and propylene yield (%). Reaction conditions: catalyst loading 0.5 g, total flow rate 50 mL min⁻¹, C₃H₈:O₂:N₂ = 1:1:4.” 이처럼 테이블 캡션은 무엇을 측정했는지, 어떤 조건에서 측정했는지, 주요 변수가 무엇인지를 명확히 포함해야 합니다.
캡션의 위치는 테이블 위(Above)에 오는 것이 국제 표준입니다. 피겨 캡션이 피겨 아래에 오는 것과 반대입니다. 이 위치 규칙을 혼동하는 연구자들이 많으므로 주의가 필요합니다.
또한 캡션에서는 약어(Abbreviation)를 처음 사용할 때 반드시 풀어서 써야 합니다. 예를 들어 ‘SD: standard deviation’, ‘n.d.: not determined’처럼 각주(Footnote)에서 정의하거나, 캡션 마지막에 ‘Abbreviations: SD, standard deviation; n.d., not determined.’처럼 목록으로 제시할 수 있습니다.
5단계: 각주(Footnote) 작성 – 정보를 보완하되 간결하게
각주(Footnote)는 테이블 본체에 담기 어려운 추가 정보를 제공하는 공간입니다. 잘 작성된 각주는 테이블의 이해도를 크게 높이지만, 과도하거나 모호한 각주는 오히려 독자를 혼란스럽게 만듭니다.
각주가 필요한 대표적인 상황은 다음과 같습니다. 첫째, 특정 데이터가 다른 방법으로 측정되었거나 다른 조건에서 얻어진 경우입니다. 둘째, 통계적 유의성(Statistical Significance)을 표시하는 경우입니다. 예를 들어 소문자 알파벳(a, b, c)으로 통계적으로 유의미하게 다른 그룹을 표시하고, 각주에서 ‘Values with different superscript letters are significantly different (p < 0.05) by Tukey’s HSD test.’처럼 설명합니다. 셋째, 특정 셀의 데이터가 누락(n.d., not determined)되거나 측정 범위를 벗어난(n.a., not applicable) 경우입니다.
각주 기호는 저널마다 다를 수 있지만, 일반적으로 위첨자(Superscript) 소문자 알파벳(a, b, c…) 또는 기호(*, †, ‡, §…)를 사용합니다. 숫자는 참고문헌(Reference) 번호와 혼동될 수 있으므로 각주 기호로 사용하지 않는 것이 좋습니다. 각주는 테이블 아래에 기호가 등장하는 순서대로 배열해야 합니다.
각주 문장은 간결하고 명확해야 합니다. 각주에서 장황한 설명을 늘어놓는 것은 피해야 하며, 필요한 정보만 핵심적으로 기술해야 합니다. 또한 각주에서 새로운 결과를 해석하거나 논의하는 것은 적절하지 않습니다. 그런 내용은 본문의 결과(Results) 또는 토론(Discussion) 섹션에서 다루어야 합니다.
6단계: 시각적 완성도(Visual Completeness) – 테이블 포맷 다듬기
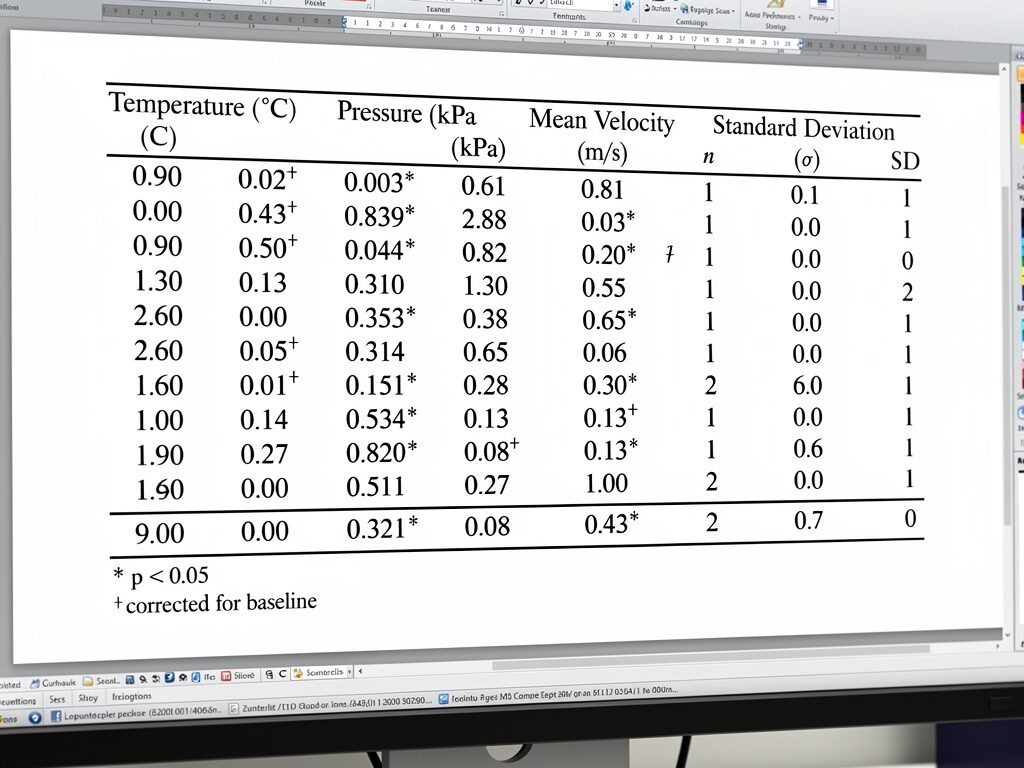
내용이 완벽하더라도 시각적으로 정돈되지 않은 테이블은 리뷰어에게 부정적인 인상을 줍니다. 테이블의 시각적 완성도는 논문의 전반적인 완성도를 반영하는 지표로 인식됩니다.
첫째, 테이블 선(Line)의 사용을 최소화하세요. 대부분의 SCI 저널은 세로선(Vertical Line)을 사용하지 않는 것을 권장합니다. 가로선(Horizontal Line)도 테이블 맨 위, 헤더와 데이터 사이, 테이블 맨 아래 세 곳에만 사용하는 것이 일반적입니다. 이를 ‘삼선 테이블(Three-line Table)’이라고 부르며, 현재 대부분의 국제 학술지에서 표준으로 채택하고 있습니다.
둘째, 숫자의 정렬(Alignment)은 소수점을 기준으로 맞춰야 합니다. 예를 들어 ‘5.32’, ‘10.15’, ‘100.00’이 같은 열에 있다면, 소수점이 수직으로 일치하도록 정렬해야 합니다. 이렇게 하면 독자가 숫자의 크기를 한눈에 비교하기 쉽습니다. 텍스트 데이터는 왼쪽 정렬(Left Alignment)이 원칙입니다.
셋째, 셀 병합(Cell Merging)은 신중하게 사용해야 합니다. 헤더에서 여러 열을 하나의 상위 카테고리로 묶을 때는 병합이 유용하지만, 데이터 셀에서의 병합은 혼란을 초래할 수 있습니다. 특히 ‘위와 동일(Same as above)’을 의미하는 병합은 절대 사용하지 마세요.
넷째, 폰트(Font) 크기와 종류는 저널의 템플릿(Template)을 따르되, 테이블 내에서는 일관성을 유지해야 합니다. 일부 연구자들이 긴 텍스트를 억지로 넣기 위해 헤더만 폰트를 작게 줄이는 경우가 있는데, 이는 전문성이 부족한 인상을 줍니다. 차라리 약어를 사용하고 각주에서 정의하는 방식을 택하세요.
다섯째, 색상(Color)의 사용은 원칙적으로 피하는 것이 좋습니다. 일부 저널은 컬러 인쇄 비용을 저자에게 청구하며, 흑백 인쇄 시 색상 구분이 불가능해져 정보가 손실될 수 있습니다. 꼭 구분이 필요하다면 색상 대신 굵은 글씨(Bold), 기울임(Italic), 또는 배경 음영(Shading)을 활용하세요.
7단계: 최종 검토(Final Review) – 제출 전 필수 체크리스트
테이블을 완성한 후에는 반드시 체계적인 최종 검토를 거쳐야 합니다. 아무리 꼼꼼하게 작성했더라도 마지막 검토를 소홀히 하면 사소한 실수가 남아 리뷰어의 지적을 받게 됩니다.
최종 검토 체크리스트는 다음과 같습니다. 첫째, 본문에서 테이블을 언급하는 순서와 테이블 번호가 일치하는지 확인합니다. ‘Table 1은 본문에서 가장 먼저 언급되어야 하고, Table 2는 그 다음에 언급되어야 합니다.’ 이 순서가 어긋나면 리뷰어에게 논문 구성이 엉성하다는 인상을 줍니다.
둘째, 테이블의 모든 데이터가 본문 결과 섹션의 서술과 일치하는지 확인합니다. 본문에서 ‘수율은 85%였다’고 썼는데 테이블에 ‘83%’가 기재되어 있다면 즉각적인 리젝션 사유가 될 수 있습니다.
셋째, 모든 약어가 각주 또는 캡션에서 정의되었는지 확인합니다. 테이블은 본문과 독립적으로 이해될 수 있어야 하므로, 본문에서 이미 정의된 약어라도 테이블에서 다시 정의해야 합니다.
넷째, 통계 표기가 올바른지 확인합니다. 평균(Mean)과 표준편차(Standard Deviation, SD)를 사용하는지, 평균과 표준오차(Standard Error, SE)를 사용하는지 명확히 구분하고, 이를 각주에서 명시해야 합니다. ‘Data are expressed as mean ± SD (n = 3).’처럼 구체적으로 표기하는 것이 좋습니다.
다섯째, 저널의 테이블 형식 요구사항(Formatting Requirements)을 다시 한번 확인합니다. 일부 저널은 테이블을 별도의 파일로 제출하도록 요구하거나, 특정 워드 프로세서(Word Processor) 형식을 요구합니다. 또한 테이블에 허용되는 최대 열 수나 행 수를 제한하는 경우도 있습니다.
실전 예시: 재료과학(Materials Science) 논문의 테이블 완성 사례
이해를 돕기 위해 실제 재료과학 논문에서 자주 등장하는 유형의 테이블 작성 사례를 살펴보겠습니다. 다음은 여러 나노복합재료(Nanocomposite)의 기계적 특성을 비교하는 테이블의 올바른 작성 예시입니다.
테이블 제목: “Table 2. Mechanical properties of epoxy/graphene nanocomposites as a function of graphene content, including tensile strength (MPa), Young’s modulus (GPa), elongation at break (%), and impact strength (kJ m⁻²). Values represent mean ± standard deviation from five independent specimens.”
헤더 구성: 첫 번째 열은 ‘Graphene Content (wt%)’, 이후 열들은 각각 ‘Tensile Strength (MPa)’, ‘Young’s Modulus (GPa)’, ‘Elongation at Break (%)’, ‘Impact Strength (kJ m⁻²)’로 구성합니다. 데이터는 그래핀(Graphene) 함량이 증가하는 순서(0, 0.5, 1.0, 2.0, 3.0 wt%)로 배열합니다.
각주 예시: “ᵃ Statistically significant difference compared to neat epoxy (p < 0.05, one-way ANOVA followed by Tukey’s post hoc test). ᵇ Values could not be measured due to brittle fracture during specimen preparation. Abbreviations: wt%, weight percent; ANOVA, analysis of variance.”
이처럼 완성된 테이블은 본문을 전혀 읽지 않아도 어떤 재료를, 어떤 조건에서, 어떤 방법으로 측정했는지, 그리고 통계 처리는 어떻게 했는지를 독자가 완전히 파악할 수 있게 해줍니다.
자주 범하는 실수 TOP 5와 해결책
마지막으로, SCI 논문 테이블 작성에서 가장 자주 발생하는 실수 5가지와 그 해결책을 정리합니다.
첫 번째 실수는 테이블과 피겨에서 동일한 데이터를 중복 제시하는 것입니다. 같은 데이터를 테이블과 피겨 두 곳에 모두 넣는 것은 저널 가이드라인 위반이며, 리뷰어에게 논문의 내용이 빈약하다는 인상을 줍니다. 해결책은 데이터의 성격에 따라 테이블 또는 피겨 중 하나를 선택하는 것입니다. 정확한 수치 비교가 중요하면 테이블을, 경향(Trend)이나 패턴(Pattern) 시각화가 중요하면 피겨를 선택하세요.
두 번째 실수는 ‘데이터 없음’을 표시하는 방법이 일관되지 않은 것입니다. ‘-‘, ‘N/A’, ‘n.d.’, 빈칸 등을 혼용하면 독자가 혼란을 겪습니다. 해결책은 논문 전체에서 하나의 표기법을 정하고 각주에서 명확히 정의하는 것입니다.
세 번째 실수는 테이블 캡션이 너무 짧거나 모호한 것입니다. 해결책은 앞서 설명한 것처럼, 캡션만 읽어도 테이블의 내용을 완전히 이해할 수 있도록 충분한 정보를 담는 것입니다.
네 번째 실수는 소수점 자릿수가 통일되지 않은 것입니다. 해결책은 테이블 작성 후 각 열을 독립적으로 검토하여 모든 데이터의 소수점 자릿수가 일치하는지 확인하는 것입니다.
다섯 번째 실수는 테이블 번호와 본문 언급 순서가 일치하지 않는 것입니다. 논문을 수정하는 과정에서 섹션의 순서가 바뀌거나 테이블이 추가·삭제되면 이런 문제가 발생합니다. 해결책은 최종 제출 전에 본문을 처음부터 끝까지 읽으면서 테이블 번호의 순서를 재확인하는 것입니다.
마치며: 테이블은 연구자의 사고 능력을 보여주는 창
SCI 논문의 테이블은 단순한 데이터 정리 도구가 아닙니다. 연구자가 자신의 데이터를 얼마나 깊이 이해하고, 얼마나 체계적으로 사고하며, 얼마나 명확하게 소통할 수 있는지를 보여주는 창입니다. 이 글에서 소개한 7단계, 즉 테이블 필요성 판단, 데이터 구조화(Data Structuring), 단위 표기(Unit Notation), 테이블 제목(Caption) 작성, 각주(Footnote) 작성, 시각적 완성도(Visual Completeness) 확보, 최종 검토(Final Review)를 차근차근 따라가면, 처음 SCI 논문을 쓰는 연구자도 심사위원이 바로 인정하는 수준의 테이블을 작성할 수 있습니다.
논문 작성은 반복과 피드백을 통해 실력이 향상됩니다. 지도교수나 선배 연구자에게 테이블 초안을 보여주고 피드백을 받는 것을 주저하지 마세요. 또한 자신이 투고하려는 저널의 최근 게재 논문들을 참고하여 그 저널이 선호하는 테이블 스타일을 파악하는 것도 매우 효과적인 전략입니다. 탄탄한 테이블 하나가 여러분의 연구를 세상에 알리는 데 결정적인 역할을 할 것입니다.
출처 및 참고자료
- 실전 SCI 논문 쓰기
- [SCI 논문 작성에 대한 소소한 팁] – 김박사넷 커뮤니티
- SCI 논문 16편 저자의 논문작성법 – 크몽
- 대학원생들을 위한 쉽게 SCI 논문 쓰는 법
- SCIE – 나무위키
이 글은 인공지능(Claude)의 분석 및 작성 보조를 받아 구성되었습니다.