포닥 연구원으로 일하면서 개인 오픈소스 프로젝트를 하나 진행하고 있습니다. 실험 데이터를 자동으로 처리하고 분석하는 도구인데, 코딩에 많은 시간을 쓰기가 어렵다 보니 자연스럽게 AI 코딩 에이전트를 활용하게 됐습니다.
처음에는 하나의 AI 서비스만 썼습니다. Claude를 주로 쓰면서 기능을 하나씩 구현해 나갔는데, 어느 정도 돌아가는 코드가 나왔을 때 막연한 불안감이 생겼습니다. “이게 제대로 된 코드인지, 내가 놓친 게 없는지 어떻게 확인하지?” 싶은 거죠.
연구에서도 마찬가지이지만, 자신의 작업을 스스로 검토하는 것에는 한계가 있습니다. 논문 리뷰어가 괜히 있는 게 아닌 것처럼, 코드도 다른 눈이 봐야 보이는 문제들이 있습니다. 그래서 저는 AI 코딩 에이전트를 두 개 쓰는 방식으로 전환했습니다.
두 AI를 동시에 쓰는 구조
제가 쓰는 방식은 단순합니다.
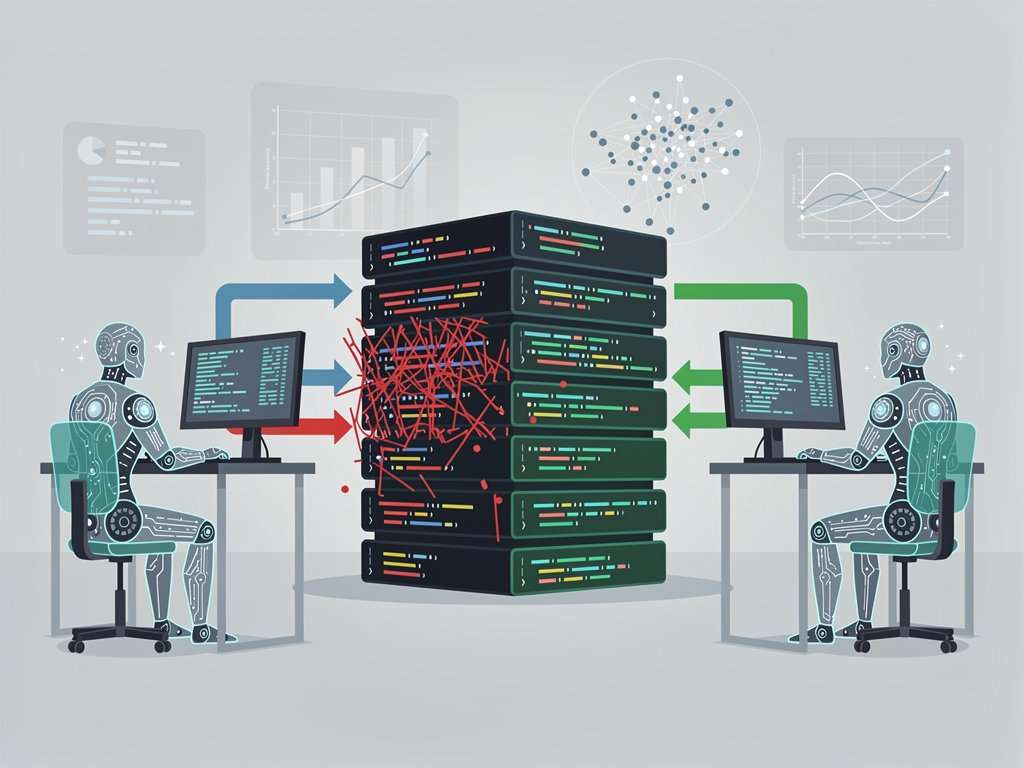
- Agent A (빌더): 실제 코드를 작성합니다. 기능 구현, 리팩토링, 버그 수정 등 생산 역할을 맡습니다.
- Agent B (리뷰어): Agent A가 작성한 코드를 받아 적대적 관점에서 검토합니다. “이 코드의 취약점은 뭔가?” “엣지 케이스를 빠뜨리진 않았나?” “더 나은 접근법은 없나?”를 집중적으로 물어봅니다.
두 AI를 같은 회사 제품으로 쓰면 비슷한 패턴으로 학습된 모델이라 리뷰의 의미가 반감될 수 있습니다. 그래서 저는 서로 다른 회사의 최상위 모델을 조합합니다. 현재는 Claude(Anthropic)와 Gemini(Google) 혹은 GPT(OpenAI)를 번갈아 리뷰어로 씁니다.
적대적 리뷰(Adversarial Review)란?
일반적인 코드 리뷰 요청은 이렇게 합니다: “이 코드 잘 됐나요?” 그러면 AI는 대부분 “잘 작성됐습니다, 다만 이런 부분을 보완하면 좋겠습니다” 식의 온화한 피드백을 줍니다.
적대적 리뷰는 다릅니다. 프롬프트 자체를 공격적으로 구성합니다:
“당신은 이 코드의 결함을 찾아내는 보안 감사자입니다. 이 코드를 실패시킬 수 있는 모든 시나리오, 숨겨진 버그, 성능 문제, 엣지 케이스를 최대한 많이 찾아내세요. 좋은 점은 언급하지 마세요.”
이런 방식으로 질문하면 AI는 칭찬 대신 문제점 발굴에 집중합니다. 실제로 이 방식으로 리뷰를 받으면서 제가 놓쳤던 것들이 쏟아져 나왔습니다.
- 파일 경로에 공백이 있을 때 발생하는 처리 오류
- 대용량 데이터셋에서 메모리 누수 가능성
- 비동기 처리 시 race condition 위험
- 에러 메시지가 사용자에게 너무 기술적으로 노출되는 문제
이 문제들을 개발 초기에 잡을 수 있었던 건 두 번째 AI 덕분이었습니다.
구독 비용 문제: 왜 최상위 플랜이어야 하는가
솔직히 말하면, 두 서비스를 동시에 구독하는 건 비용 부담이 있습니다. Claude Pro와 ChatGPT Plus를 각각 구독하면 한 달에 40달러가 넘습니다. 포닥 월급으로는 만만치 않은 금액입니다.
그런데 저는 최상위 플랜을 쓰는 게 결국 더 경제적이라는 결론에 도달했습니다. 그 이유는 사용 패턴에 있습니다.
연구자의 코딩 작업은 매일 꾸준히 하는 게 아니라, 집중적으로 몰아서 하는 경우가 많습니다. 실험 사이사이에 반나절, 혹은 하루를 통째로 코딩에 투자하는 방식입니다. 이런 패턴에서는 사용량이 많지 않은 날이 대부분이고, 작업이 집중되는 날에 고품질 응답이 한 번에 많이 필요합니다.
무료 또는 저가 플랜의 모델을 쓰면 응답 품질이 떨어지거나 컨텍스트 창이 작아서, 큰 코드베이스를 한 번에 검토받기가 어렵습니다. 결국 여러 번 나눠서 질문하고 그 결과를 제가 직접 조합해야 하는 오버헤드가 생깁니다.
반면 최상위 모델은 긴 코드 전체를 한 번에 파악하고 구조적 문제까지 짚어줍니다. 작업 효율이 근본적으로 다릅니다. 비용 대비 절약되는 시간을 따져보면 최상위 플랜이 맞습니다.
실전에서 쓰는 워크플로우
제가 실제로 쓰는 프로세스를 간단히 공유합니다.
- 기능 명세 작성: 구현하고 싶은 기능을 한국어로 명확하게 써두기
- Agent A로 코드 생성: “이 명세대로 Python 코드를 작성해줘”
- 코드 1차 확인: 대략적으로 의도한 대로 동작하는지 직접 실행해서 확인
- Agent B에 적대적 리뷰 요청: 전체 코드를 붙여넣고 위에서 언급한 공격적 프롬프트 사용
- 리뷰 결과를 다시 Agent A에게: “이 리뷰 피드백을 반영해서 코드를 수정해줘”
- 최종 확인 후 커밋
이 루프를 한 기능당 1~2번 돌리면 혼자 짤 때보다 훨씬 탄탄한 코드가 나옵니다. 특히 오픈소스라면 다른 사람이 예상치 못한 환경에서도 쓸 수 있어야 하기 때문에, 이런 다층 검토가 중요합니다.
마치며
AI 코딩 에이전트를 쓰는 것만으로도 개발 속도가 크게 올라갑니다. 그런데 한 AI만 믿고 결과물을 그냥 쓰는 건 위험할 수 있습니다. AI도 틀립니다. 더구나 같은 모델이 스스로를 검토할 때는 자신의 편향을 그대로 유지한 채로 리뷰하기 때문에 치명적인 문제를 놓칠 수 있습니다.
두 번째 AI를 적대적 리뷰어로 쓰는 전략은, 논문 작성 후 다른 연구자에게 검토를 부탁하는 것과 같은 맥락입니다. 추가 비용이 들더라도 코드 품질에 확신을 갖고 배포할 수 있다면 그만한 가치가 있다고 생각합니다. 특히 오픈소스라면 더더욱 그렇습니다.
비슷한 방식으로 개인 프로젝트를 진행하고 계신 분들께 한 번 시도해보시길 권합니다.
함께 읽으면 좋은 글
- AI가 만들어낸 참고문헌, 발표장에서 들통났습니다 – 연구자가 알려주는 AI 제대로 쓰는 법
- 화학공학과 코딩 수업, 대충 들은 죄로 대학원에서 몇 배로 갚았다
- AI와 딥러닝은 도구일 뿐, 맹신하지 말아야 한다
💡 저자의 경험: 이 글은 대학원 생활 중 직접 경험하면서 얻은 실제 사례를 바탕으로 작성되었습니다.